Was kostet ein LLM? Preisleitfaden für 2026

Wenn Sie einen Marktplatz, ein SaaS-Produkt oder eine Anwendung entwickeln, die auf künstlicher Intelligenz basiert, ist es entscheidend zu verstehen, was ein LLM kostet. Die Antwort ist nicht trivial, da verschiedene Kostenmodelle mit unterschiedlichen Preisstrukturen existieren. Ob Sie nun die Integration eines LLM in Ihr Produkt planen oder eigene KI-Funktionen entwickeln: Die Kenntnis der tatsächlichen Kosten hilft Ihnen dabei, fundierte Entscheidungen über die Wahl der Modelle und die Architektur Ihrer Anwendung zu treffen.
Oft herrscht Verwirrung zwischen zwei sehr unterschiedlichen Kostenszenarien. Auf der einen Seite stehen die enormen Kosten für das Training eines hochmodernen Sprachmodells von Grund auf. Auf der anderen Seite stehen die deutlich zugänglicheren Kosten für den Aufruf eines bestehenden Modells über eine API. Für die meisten Marktplatz-Gründer und Produktteams ist Letzteres entscheidend. Journeyhorizon arbeitet mit Marktplatzbetreibern zusammen, die zunehmend KI-Funktionen in ihre Plattformen integrieren. Das Verständnis dieser Kosten ist für die Produktplanung von entscheidender Bedeutung.
Die zwei Welten der LLM-Kosten
Wenn die Frage aufkommt, was ein LLM kostet, denken die meisten Menschen an eines von zwei Dingen. Das Training eines neuen Spitzenmodells ist extrem teuer. Die Entwicklung von Systemen wie GPT-4 oder Claude erfordert Hunderte Millionen Dollar für Recheninfrastruktur, spezialisierte Hardware wie NVIDIA H100-GPUs (die jeweils etwa 25.000 US-Dollar kosten) sowie Teams aus Forschern und Ingenieuren. Allein die Rechenkosten für Spitzenmodelle liegen zwischen 78 und über 192 Millionen US-Dollar – nur für Hardware und Rechenzeit. Rechnet man die Kosten für hochwertige Trainingsdaten, das verstärkende Lernen durch menschliches Feedback (RLHF) und die laufende Infrastruktur hinzu, belaufen sich die kumulierten Investitionen auf Milliarden.
Doch das sind nicht Ihre Kosten. Ein eigenes LLM von Grund auf zu entwickeln, ist nur sinnvoll, wenn Sie ein finanzstarkes KI-Unternehmen mit spezifischen Wettbewerbsanforderungen sind. Für alle anderen – Marktplatz-Gründer, SaaS-Teams und Unternehmen – sind die API-Preise relevant. Sie zahlen pro generiertem Token, was wesentlich überschaubarer ist und mit Ihrer tatsächlichen Nutzung skaliert.
Die aktuelle LLM-API-Preislandschaft
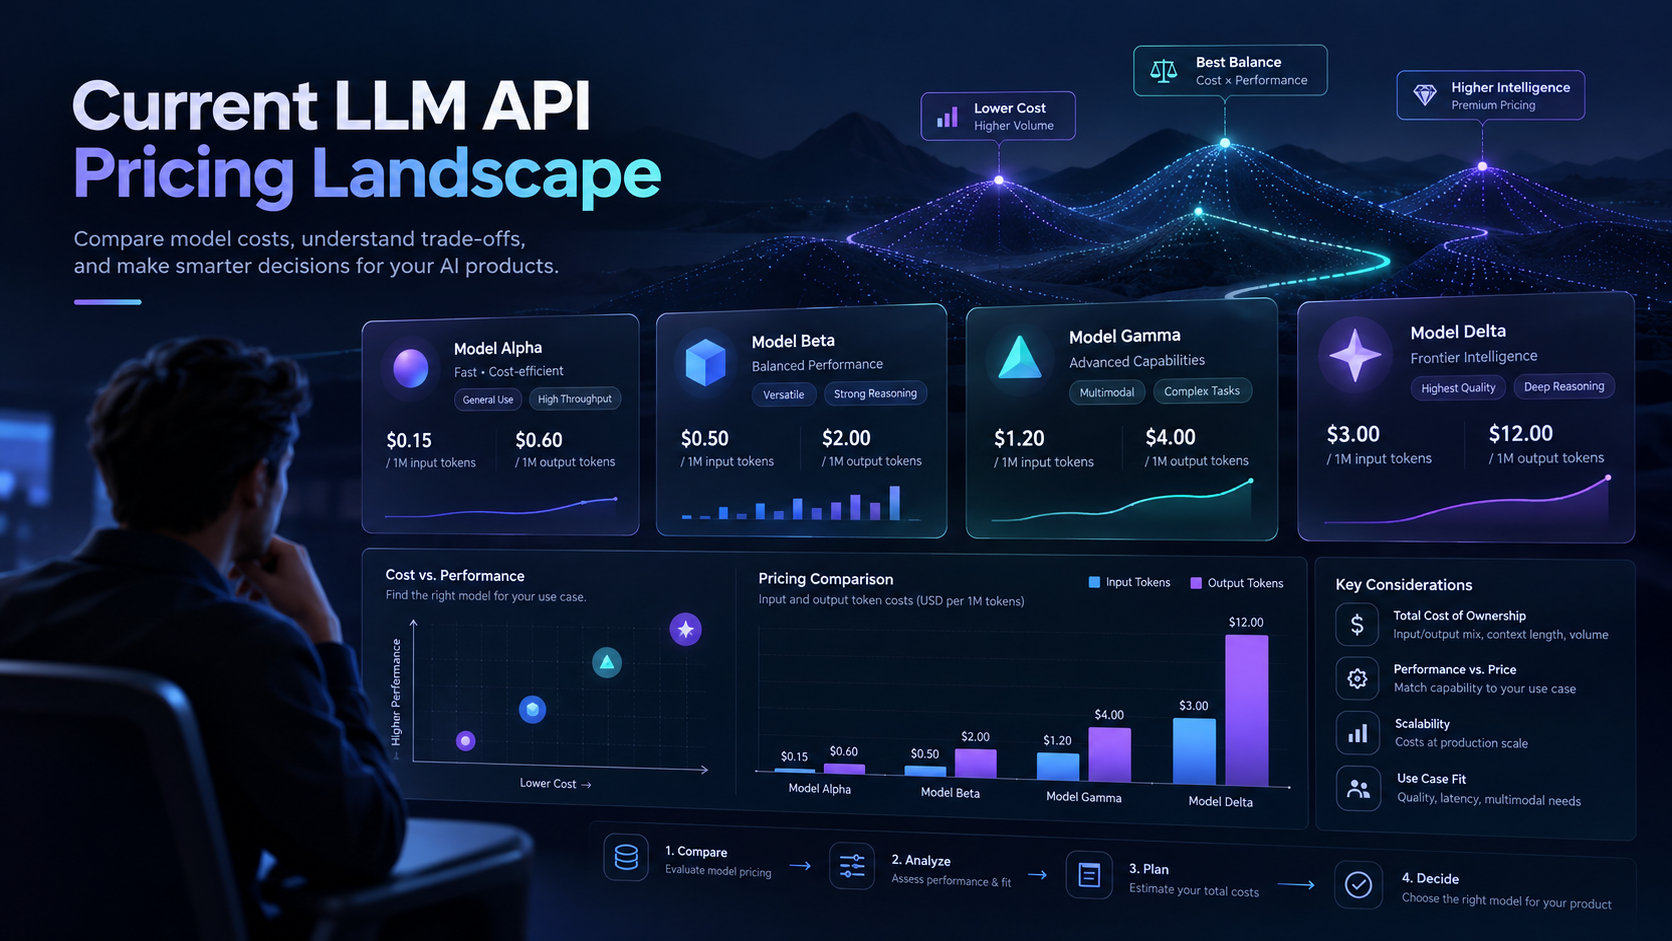
Die Kosten für die Nutzung eines LLM über eine API sind mittlerweile bemerkenswert wettbewerbsfähig. Budgetfreundliche Modelle wie Amazon Nova Micro kosten nur 0,035 US-Dollar pro Million Input-Token und 0,14 US-Dollar pro Million Output-Token. Wenn Sie etwas Leistungsfähigeres, aber dennoch Kosteneffizientes benötigen, berechnet DeepSeek-V3.2 0,28 US-Dollar pro Million Input-Token und 0,42 US-Dollar für Outputs. Im mittleren Bereich kostet Claude Haiku 4.5 1 US-Dollar pro Million Input-Token und 5 US-Dollar für Outputs, während GPT-4o Mini bei 0,15 US-Dollar für Input und 0,60 US-Dollar für Output pro Million Token liegt.
Im oberen Leistungsbereich kosten Claude Sonnet 5.5 und Claude Opus 5.5 2 bzw. 4 US-Dollar pro Million Input-Token, bei Output-Kosten von 10 bzw. 20 US-Dollar. GPT-5 und ähnliche Spitzenmodelle bewegen sich im Bereich von 1,25 bis 2,50 US-Dollar für Inputs. Die leistungsstärksten Reasoning-Modelle – wie o1 Pro – kosten 150 US-Dollar pro Million Input-Token und 600 US-Dollar für Outputs, sind jedoch für spezifische, hochwertige Anwendungsfälle konzipiert, bei denen die Kosten durch die Komplexität des Problems gerechtfertigt sind.
Entscheidend ist, dass sich das Preis-Leistungs-Verhältnis drastisch verbessert hat. Vor einem Jahr waren leistungsfähige Modelle deutlich teurer. Heute können Sie eine funktionsreiche Anwendung mit hochentwickelter KI erstellen, ohne Ihr Infrastrukturbudget zu sprengen. Viele Marktplatz-Plattformen bieten mittlerweile KI-gestützte Funktionen wie intelligente Suche, automatisierte Kategorisierung, Inhaltsmoderation und personalisierte Empfehlungen an, die diese preisgünstigen Modelle nutzen.
Wie sich LLM-Preise tatsächlich zusammensetzen
Die API-Preisgestaltung basiert fast immer auf Token, nicht auf Anfragen oder Zeit. Ein Token entspricht in etwa einem Wort oder einem Teil eines Wortes (Satzzeichen, Ziffern usw. werden unterschiedlich gezählt). Die meisten Modelle berechnen Input-Token (den Prompt, den Sie senden) und Output-Token (die Antwort, die das Modell generiert) separat. Output-Token kosten in der Regel zwei- bis fünfmal mehr als Input-Token, da die Generierung von Text rechenintensiver ist als dessen Verarbeitung.
Auch die Größe des Kontextfensters spielt eine Rolle. Einige Modelle bieten günstigere Tarife für kleinere Kontextfenster an (die Menge an vorangegangener Konversation oder Text, auf die das Modell zugreifen kann). Ein Modell mit einem 128K-Token-Kontextfenster berechnet möglicherweise den Standardtarif, während dasselbe Modell mit einem 1M-Token-Fenster pro Token mehr kostet, da es mehr Rechenleistung erfordert. Caching – bei dem häufig verwendeter Kontext gespeichert wird, um eine erneute Verarbeitung zu vermeiden – wird zum Standard und kann die Kosten drastisch senken, wenn Ihre Anwendung wiederholt ähnliche Prompts sendet.
Um die tatsächlichen Kosten zu berechnen, müssen Sie Ihr Nutzungsmuster kennen. Eine Marktplatz-Empfehlungs-Engine, die Hunderte von Artikeln pro Sekunde verarbeitet, hat eine andere Kostendynamik als ein Inhaltsmoderationssystem, das bei bestimmten Auslösern aktiv wird. Wenn Sie eine intelligente Suche für Ihren Marktplatz entwickeln, generieren Sie möglicherweise nur einmal pro Suchanfrage einen Output. Wenn Sie eine Chat-Schnittstelle für den Kundensupport aufbauen, generieren Sie kontinuierlich Outputs. Die Token-Anzahl summiert sich in jedem Szenario anders.
Praxisnahe Kostenschätzung für Marktplatz-Funktionen
Gehen wir ein praktisches Beispiel durch. Angenommen, Sie entwickeln eine intelligente Kategorisierungsfunktion für Ihren Marktplatz, die Angebote automatisch mit Tags versieht. Sie verarbeiten 10.000 Angebote pro Tag, wobei jeder Kategorisierungs-Prompt etwa 100 Input-Token kostet und 50 Output-Token als Antwort liefert. Mit Claude Haiku 4.5 sind das täglich 1 Million Input-Token und 500.000 Output-Token, was etwa 1,50 US-Dollar pro Tag oder 45 US-Dollar pro Monat allein für diese Funktion kostet. Skalieren Sie dies auf eine Million Artikel pro Monat, liegen Sie bei 1.500 US-Dollar monatlichen Kosten für eine wirklich nützliche Funktion.
Betrachten wir nun ein anderes Szenario. Sie bauen eine Suchoberfläche in natürlicher Sprache, bei der Kunden Fragen in einfachem Englisch stellen und das System Ihre Angebote durchsucht. Jede Suche generiert vielleicht 200 Input-Token und 100 Output-Token. Wenn Ihr Marktplatz 100.000 Suchanfragen pro Monat abwickelt, sind das 20 Millionen Input-Token und 10 Millionen Output-Token monatlich, was zu Claude-Haiku-Preisen etwa 30 US-Dollar kostet. Dieselbe Funktion mit einem leistungsfähigeren Modell wie Claude Sonnet würde bei gleichem Volumen 200 US-Dollar pro Monat kosten.
Dies sind keine unerheblichen Kosten, aber sie sind vorhersehbar und skalieren linear mit der Nutzung. Der Schlüssel liegt darin, Ihren spezifischen Anwendungsfall zu verstehen und das richtige Modell für die jeweilige Aufgabe zu wählen. Sie benötigen kein Claude Opus oder GPT-5 für einfache Kategorisierungen oder Suchen. Sie brauchen kein Reasoning-Modell für das Routing von Kundensupport-Anfragen. Die Abstimmung der Modellkapazität auf die Komplexität der Aufgabe ist der Weg, wie Sie Ihre Ausgaben optimieren.
Strategien zur Verwaltung von LLM-Kosten
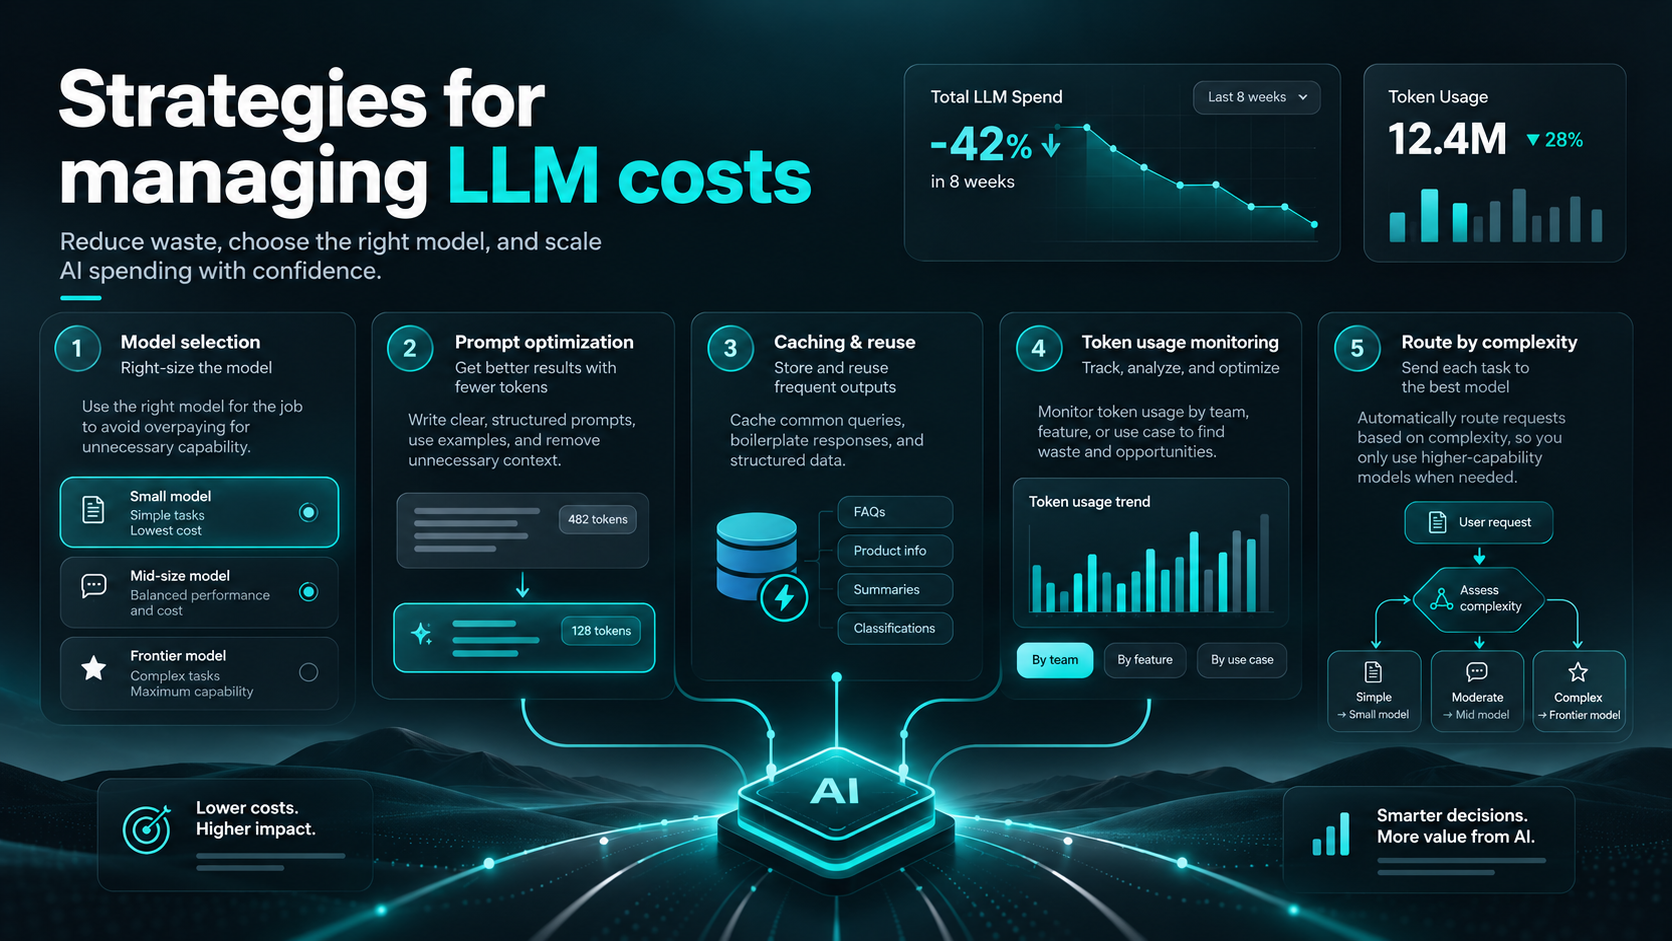
Die erste Optimierung besteht darin, das richtige Modell für Ihre spezifische Aufgabe zu wählen. Eine Anwendung, die von ausgefeiltem logischem Denken profitiert, rechtfertigt möglicherweise die höheren Kosten von Claude Sonnet, während einfache Klassifizierungen oder Routings problemlos mit Haiku oder ähnlichen Modellen funktionieren. Ein Benchmarking Ihrer Aufgabe mit verschiedenen Modellen hilft dabei, den optimalen Punkt zu finden.
Prompt-Engineering reduziert den Token-Verbrauch. Kürzere, fokussiertere Prompts verbrauchen weniger Token als weitschweifige. Klare Anweisungen und Beispiele in Ihrem System-Prompt sparen tatsächlich Token, da sie Rückfragen zur Klärung reduzieren. Tools wie Prompt Caching ermöglichen es Ihnen, teuren Kontext (wie Ihren Produktkatalog oder Styleguide) zu speichern, sodass er nur einmal verarbeitet und über Anfragen hinweg wiederverwendet wird.
Das Bündeln von Anfragen ist ein weiterer Ansatz, sofern Ihr Workflow dies zulässt. Anstatt für jedes Element einzelne API-Aufrufe zu tätigen, können Sie Elemente in Gruppen verarbeiten und so den Overhead amortisieren. Rate Limiting – das bewusste Drosseln von Anfragen zu Spitzenzeiten – mag kontraintuitiv erscheinen, kann aber wirtschaftlich sein, wenn es Ihnen ermöglicht, Arbeit auf kostengünstigere Zeiten zu verlagern oder redundante Anfragen zu reduzieren. Einige Marktplatzfunktionen benötigen keine Echtzeitergebnisse, daher ist eine Stapelverarbeitung über Nacht durchaus praktikabel.
Hybride Ansätze funktionieren ebenfalls. Verwenden Sie ein kleineres, günstigeres Modell für ein erstes Screening und leiten Sie nur unsichere Fälle zur Verfeinerung an ein leistungsfähigeres (und teureres) Modell weiter. Klassifizieren Sie die meisten Angebote automatisch, leiten Sie jedoch ungewöhnliche oder mehrdeutige Fälle an eine menschliche Überprüfung weiter. Dies führt oft zu besseren Ergebnissen, als zu versuchen, jeden Fall mit einem einzigen Modell zu lösen.
Die Auswirkungen für Marktplatz-Betreiber
Für Marktplatz-Gründer, die über die Integration von LLMs nachdenken, ist die Kostenlandschaft bei durchdachter Planung durchaus zugänglich. Sie können es sich leisten, KI-Funktionen hinzuzufügen, ohne massiv in die Infrastruktur investieren zu müssen. Ein Generator für Angebotsbeschreibungen, ein Chatbot für den Verkäufersupport oder eine intelligente Suchoberfläche sind für einen gebootstrappten Marktplatz oder ein finanziertes Team mit einem angemessenen Budget durchaus erreichbar.
Die eigentliche Frage ist nicht, ob Sie sich LLMs leisten können – das können Sie wahrscheinlich. Die Frage ist, ob die Funktion die Kosten durch verbesserte Konversion, Kundenbindung oder betriebliche Effizienz rechtfertigt. Ein Marktplatz, der Verkäufern hilft, bessere Beschreibungen zu schreiben, könnte eine bessere Suchleistung und höhere Umsätze verzeichnen. Intelligente Moderation reduziert die Kosten für die menschliche Überprüfung. Intelligentes Routing im Support verkürzt die Antwortzeiten. Diese Funktionen haben einen geschäftlichen Mehrwert, der über die bloße Neuheit von „Wir haben KI“ hinausgeht.
Wenn Sie einen Marktplatz skalieren und benutzerdefinierte KI-Funktionen oder Integrationen in Betracht ziehen, insbesondere solche, die nahtlos mit Ihrer Plattformarchitektur zusammenarbeiten müssen, ist die Zusammenarbeit mit einem Partner, der sowohl die LLM-Kosten als auch die Marktplatzdynamik versteht, wertvoll. Journeyhorizon hat KI-Kostenoptimierungs- strategien speziell für Marktplatz- und SaaS-Unternehmen entwickelt. Wir helfen Teams dabei, die richtigen Modelle auszuwählen, effiziente Integrationen zu konzipieren und die Ausgaben bei der Skalierung von KI-Funktionen zu verwalten. Egal, ob Sie eine Empfehlungs-Engine hinzufügen, die Moderation automatisieren oder benutzerdefinierte Workflows erstellen: Das Verständnis der technischen und finanziellen Dimensionen hilft Ihnen dabei, Funktionen bereitzustellen, die Ihre Nutzer lieben, ohne dabei das Budget zu sprengen.
Häufig gestellte Fragen
Was sind Input- und Output-Token und warum kosten sie unterschiedlich viel?
Input-Token sind die Wörter und Zeichen in Ihrem Prompt oder Ihrer Frage, die an das LLM gesendet werden. Output-Token sind die Wörter, die das LLM als Antwort generiert. Output-Token kosten in der Regel mehr (oft das Drei- bis Fünffache), da die Generierung von Text mehr Rechenleistung erfordert als die Verarbeitung eines eingehenden Prompts. Berücksichtigen Sie bei der Bewertung der Kosten eines LLM immer sowohl die Input- als auch die Output-Raten.
Kann ich kostenlose LLM-Modelle verwenden, um Kosten zu vermeiden?
Ja, Open-Source-Modelle wie Llama und Mistral können selbst gehostet werden, wodurch pro-Token-API-Gebühren entfallen. Das Selbst-Hosting erfordert jedoch Investitionen in die Infrastruktur, laufende Wartung und Zeit für die technische Umsetzung. Für viele Teams ist die Bezahlung des API-Zugriffs auf ein gut gewartetes Modell günstiger und einfacher als die Verwaltung einer eigenen Bereitstellung. Wenn Ihr Volumen sehr hoch ist oder Ihr Anwendungsfall besonders sensibel in Bezug auf den Datenschutz ist, kann Selbst-Hosting sinnvoll sein.
Wie schätze ich die LLM-Kosten für meinen spezifischen Anwendungsfall ein?
Ermitteln Sie zunächst die durchschnittliche Anzahl der Eingabe- und Ausgabetoken pro Anfrage. Führen Sie einige Test-Prompts über die API Ihrer Wahl aus und zählen Sie die Token (die meisten API-Dashboards zeigen dies an). Multiplizieren Sie diesen Wert mit Ihrem erwarteten monatlichen Anfragevolumen. Bei 100.000 Anfragen pro Monat mit jeweils 200 Eingabe- und 100 Ausgabetoken würden beispielsweise allein für die Nutzung von Claude Haiku monatliche LLM-Kosten von etwa 30 $ anfallen.
Sinken die Preise für LLMs?
Ja. In den letzten 12 bis 24 Monaten sind die Preise für die meisten LLMs deutlich gesunken. Neuere Modelle kommen oft günstiger auf den Markt als ihre Vorgänger, da der Wettbewerb zwischen den API-Anbietern zugenommen hat. Budget-Modelle wie Amazon Nova und DeepSeek haben die Preise weiter gedrückt. Spitzenmodelle (die leistungsfähigsten Varianten) bleiben jedoch teuer, und daran wird sich in naher Zukunft voraussichtlich wenig ändern.