So reduzieren Sie den Token-Verbrauch für KI-Marktplatz-Funktionen
Wenn Sie einen Marktplatz mit KI-gestützten Funktionen entwickeln, sind Token-Kosten kein bloßes Hintergrundrauschen mehr. Jedes von einem LLM sortierte Suchergebnis, jede automatisch generierte Produktbeschreibung und jede von einem Modell weitergeleitete Käuferanfrage schlägt auf der Rechnung zu Buche. Dieser Leitfaden erklärt, wie Sie den Token-Verbrauch senken, ohne die Qualität zu opfern, die KI-Funktionen erst wertvoll macht.
Bei Journeyhorizonarbeiten wir seit 2018 mit Marktplatz-Gründern zusammen. Dabei zeigt sich ein wiederkehrendes Muster: Die erste Version funktioniert, doch sobald echter Traffic einsetzt, steigt die Kostenkurve steil an. Die gute Nachricht ist, dass sich der Großteil dieser Kosten auf wenige Bereiche konzentriert und die Lösungen dafür hinlänglich bekannt sind.
Wie die Token-Preisgestaltung für KI-Funktionen auf Marktplätzen funktioniert
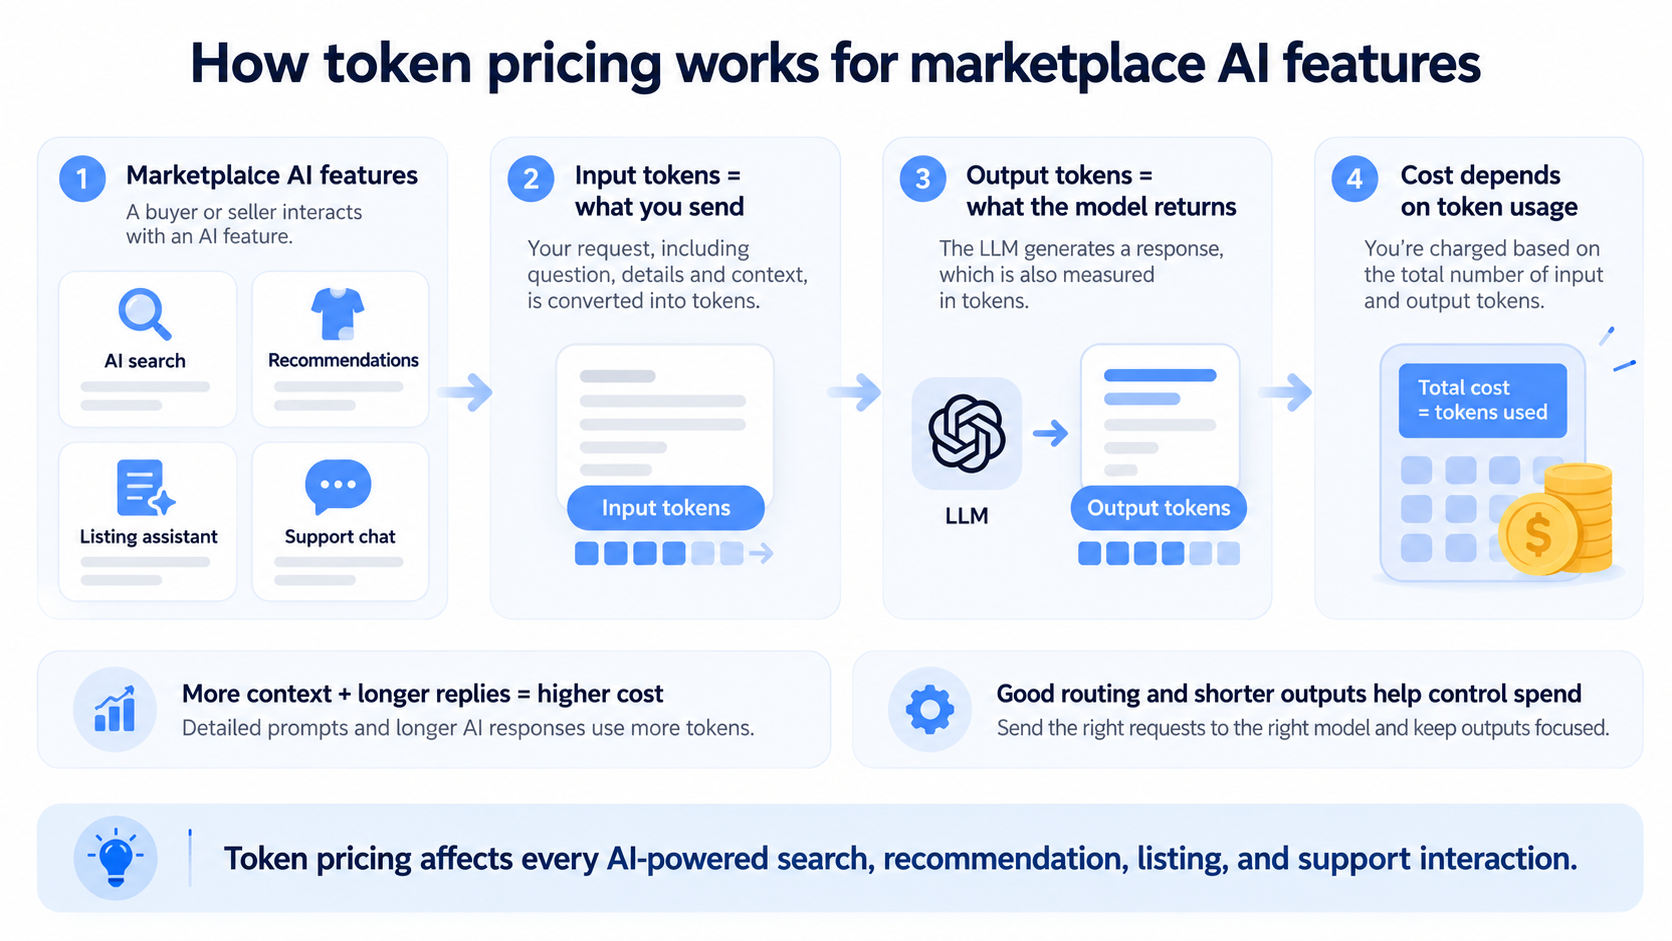
Wenn Sie eine LLM-API aufrufen, zahlen Sie für Input-Token (alles, was Sie senden: System-Prompt, Anweisungen, abgerufener Kontext, Gesprächsverlauf) und Output-Token (alles, was das Modell generiert). Output ist deutlich teurer. Stand Oktober 2026 listet Anthropic Claude Sonnet 5.5 mit 2 $ pro Million Input-Token und 10 $ pro Million Output-Token; OpenAI führt gpt-6.1-sol zu denselben Preisen von 2 $ bzw. 10 $. Kleinere Modelle sind weitaus günstiger: Claude Haiku 5.5 und OpenAIs gpt-6-luna kosten jeweils 0,10 $ für Input und 0,50 $ für Output pro Million Token, und Google bietet Gemini 3.8 Flash für 0,75 $ bzw. 3,75 $ an.
Drei Details überraschen viele Gründer:
- Output kostet etwa fünfmal so viel wie Input bei diesen Modellen, daher kann eine ausführliche Antwort teurer sein als ein langer Prompt.
- Reasoning-Token werden als Output abgerechnet. Ein Reasoning-Modell, das 2.000 Token „nachdenkt“, bevor es eine 100-Token-Antwort gibt, stellt Ihnen 2.100 Output-Token in Rechnung.
- Die Preisunterschiede zwischen den Modellklassen sind groß. Laut Listenpreisen kann ein Spitzenmodell etwa 20-mal mehr pro Token kosten als ein kleines Modell desselben Anbieters.
Für einen vollständigen Vergleich der Anbieter und der versteckten Kosten hinter den Listenpreisen lesen Sie unsere LLM-API-Preisvergleich für Marktplätze, und für eine allgemeinere Einführung lesen Sie wie viel ein LLM im Jahr 2026 kostet.
Für einen Marktplatz erzeugt diese Kostenstruktur spezifische Druckpunkte. Wenn ein LLM Suchergebnisse sortiert, wird jede Anfrage zu einem API-Aufruf, der Listendaten und Nutzersignale enthält. Im Gegensatz zum Hosting, das weitgehend Fixkosten verursacht, skalieren LLM-Ausgaben mit der Nutzung – ein Traffic-Anstieg wird also zum Kostenanstieg. Falls Sie noch evaluieren, welche Funktionen sich lohnen, deckt unser Leitfaden zu wie Marktplätze KI nutzen die gängigen Anwendungsfälle ab.
Schritt 1: Messen Sie, wohin Ihre Token fließen
Man kann nicht optimieren, was man nicht misst, und die meisten Teams achten erst auf den Token-Verbrauch, wenn die Rechnung eintrifft.
Jede gängige API gibt die Token-Anzahl in der Antwort zurück. Protokollieren Sie diese für jeden Aufruf zusammen mit dem Funktionsnamen, dem Modell, der Benutzer- oder Listing-ID sowie den Feldern zur Cache-Nutzung (Anthropic gibt beispielsweise die Anzahl der Token für Cache-Erstellung und Cache-Lesevorgänge zurück, OpenAI die Anzahl der zwischengespeicherten Token). Mit diesen Daten können Sie die entscheidenden Fragen beantworten:
- Welche Funktionen verbrauchen die meisten Token pro Tag?
- Wie hoch ist die durchschnittliche Token-Anzahl pro Anfrage und wie hoch ist der 95. Perzentil-Wert?
- Wie hoch ist Ihre Cache-Trefferquote?
Betrachten Sie Token-Kosten wie ein Leistungsbudget, genau wie Sie die Seitenladezeit überwachen. Legen Sie ein Limit pro Vorgang fest (zum Beispiel eine Obergrenze für Eingabe- und Ausgabe-Token pro Suchranking-Aufruf) und lassen Sie sich benachrichtigen, wenn ein Release dieses Limit überschreitet. Dashboards, Warnmeldungen und Attribuierung behandeln wir ausführlich in unserem Leitfaden zu LLM-Kostenüberwachung für Marktplätze.
Schritt 2: Architekturentscheidungen zur Kontrolle der Token-Kosten
Die größten Einsparungen ergeben sich aus frühzeitigen architektonischen Entscheidungen.
Senden Sie nur den Kontext, den das Modell benötigt
Kontext-Inflation ist die häufigste Ursache für Verschwendung. Beim Ranking von Suchergebnissen ist es verlockend, den vollständigen Verlauf des Benutzers, jedes Listing-Attribut, alle Bewertungen und den aktuellen Marktplatzstatus zu senden. Das wirkt zwar gründlich, aber das meiste davon ändert nichts am Ergebnis. Ein fokussierter Ansatz sendet die Suchanfrage, eine kurze Zusammenfassung jedes potenziellen Listings und eine Handvoll Verhaltenssignale. Praktische Wege hierfür sind:
- Berechnen Sie vorab eine kompakte Zusammenfassung für jedes Listing, speichern Sie diese und senden Sie diese anstelle des vollständigen Datensatzes.
- Nutzen Sie Retrieval, um zuerst die besten Kandidaten auszuwählen und senden Sie nur diese an das Modell.
- Entfernen Sie HTML, Boilerplate-Code und doppelte Felder. Bereinigter Text oder Markdown verbraucht weitaus weniger Token als rohes Seiten-Markup.
Verwenden Sie das LLM nicht, wenn Sie es nicht brauchen
Viele Aufgaben, die mit „KI verwenden“ beginnen, lassen sich besser mit einfacheren Tools lösen. Das Sortieren nach Preis oder Entfernung ist eine Datenbankabfrage. Schlüsselwort- und semantisches Retrieval können über einen Suchindex oder eine Vektorsuche abgewickelt werden, wobei das LLM für das abschließende Reranking oder die Interpretation vager Anfragen reserviert bleibt. Nutzen Sie LLMs dort, wo sie einen echten Mehrwert bieten (Verständnis von Absichten, nuancierte Urteile, Schreiben) und vermeiden Sie sie dort, wo günstigere, schnellere Tools ausreichen.
Leiten Sie Aufgaben an das richtige Modell weiter
Modell-Routing sendet jede Anfrage an das günstigste Modell, das sie zuverlässig verarbeiten kann. Klassifizierung, Tagging, kurze Extraktion und Vorab-Moderation laufen meist gut auf kleinen Modellen. Komplexe Schlussfolgerungen, längere Texte oder sensible Entscheidungen rechtfertigen möglicherweise ein Frontier-Modell. Die Forschung stützt dies: Das RouteLLM-Paper berichtete von Kosteneinsparungen um mehr als das Zweifache in einigen Szenarien, ohne die Qualität zu beeinträchtigen. Das FrugalGPT-Paper, das nur bei Bedarf von günstigen auf teure Modelle eskaliert, berichtete von bis zu 98 % Kostenreduzierung in seinen Testreihen. Ihre Ergebnisse werden variieren, bewerten Sie daher anhand Ihrer eigenen Daten.
Ein einfaches Muster ist eine Kaskade: Versuchen Sie es zuerst mit dem kleinen Modell, validieren Sie die Ausgabe (Schema-Prüfungen, Konfidenzwert oder eine Regel) und eskalieren Sie nur bei Fehlern. Denken Sie daran, die Kosten für Wiederholungsversuche und Eskalationen einzurechnen, wenn Sie Optionen vergleichen.
Schritt 3: Prompt-Engineering zur Reduzierung des Token-Verbrauchs
Wie Sie Prompts formulieren, wirkt sich direkt auf die Eingabe- und Ausgabe-Token aus.
- Fassen Sie sich kurz und werden Sie konkret. Entfernen Sie wiederholte Anweisungen und Füllwörter, die das Modell nicht benötigt.
- Setzen Sie Beispiele gezielt ein. Ein gutes Beispiel kann ganze Absätze an Anweisungen ersetzen, verbraucht jedoch bei jedem Aufruf zusätzliche Input-Token. Beschränken Sie sich auf ein oder zwei kurze Beispiele und legen Sie diese im gecachten Teil des Prompts ab.
- Beschränken Sie die Ausgabe. Wenn Sie nur eine Kategorie und einen Score benötigen, fordern Sie genau das im JSON-Format an. Legen Sie ein Wortlimit fest, weisen Sie das Modell an, auf Erklärungen zu verzichten, wenn diese nicht erforderlich sind, und setzen Sie ein hartes Limit für die maximale Anzahl an Ausgabe-Token.
- Steuern Sie den Denkprozess. Nutzen Sie bei Reasoning-Modellen den geringsten Denkaufwand, der für die Qualität der Aufgabe noch akzeptabel ist, da verborgene Denkprozesse als Ausgabe berechnet werden.
- Verwenden Sie Vorlagen. Wiederverwendbare Vorlagen mit Platzhaltern sorgen für konsistente Prompts, sind cache-freundlich und lassen sich leicht für A/B-Tests hinsichtlich Token-Anzahl und Qualität optimieren.
Für große, unstrukturierte Eingaben, die sich nicht an der Quelle kürzen lassen, gibt es Tools zur Prompt-Kompression. Microsoft Researchs LLMLingua berichtete in Experimenten von einer bis zu 20-fachen Kompression der Prompts bei geringem Leistungsverlust. Kompression erhöht jedoch die Komplexität und sollte erst erfolgen, nachdem Sie unnötigen Kontext bereits entfernt haben.
Schritt 4: Caching und Batching für skalierbare KI-Funktionen
Provider-Prompt-Caching
Durch Prompt-Caching kann der Provider einen wiederkehrenden Prompt-Präfix – wie Systemanweisungen, Ranking-Regeln oder Kategorietaxonomien – zu einem deutlich günstigeren Preis wiederverwenden. Da die Ausgabe unverändert bleibt, ist dies eine der risikoärmsten Möglichkeiten zur Kosteneinsparung.
- Anthropic: Laut der Dokumentation von Anthropic kosten Cache-Schreibvorgänge das 1,25-fache des Basis-Input-Preises bei einer Standardlebensdauer von 5 Minuten (die bei jeder Cache-Nutzung aktualisiert wird). Cache-Lesevorgänge bei Claude Sonnet 5.5 kosten das 0,05-fache des Basis-Inputs, was 0,10 $ pro Million Token entspricht. Prompts müssen eine Mindestlänge (512 Token bei den 5.5-Modellen) aufweisen, um gecacht werden zu können.
- OpenAI: Die Dokumentation von OpenAI besagt, dass Caching für unterstützte Modelle standardmäßig aktiviert ist. Für GPT-5.6 und spätere Versionen müssen Prompts mindestens 1.024 Token umfassen. Cache-Lesevorgänge kosten das 0,1-fache der ungecachten Input-Rate (0,05-fach bei gpt-6.1-sol), während Cache-Schreibvorgänge das 1,25-fache kosten.
Um Cache-Treffer zu erzielen, halten Sie den stabilen Teil des Prompts identisch und platzieren Sie ihn am Anfang. Dynamische Inhalte (Benutzeranfragen, spezifische Auflistungen, Zeitstempel) sollten am Ende stehen. Die Änderung eines einzigen Zeichens im Präfix, das Umordnen von Tools oder das Einfügen des Datums am Anfang führt dazu, dass der Cache ungültig wird. Beachten Sie, dass Caching die ersten Anfragen nicht verlangsamt; der Kompromiss ist ein kleiner Aufschlag beim Schreiben in den Cache, der sich amortisiert, sobald derselbe Präfix wiederverwendet wird.
Caching auf Anwendungsebene
Mit einem eigenen Cache lassen sich API-Aufrufe komplett vermeiden. Speichern Sie generierte Artikelbeschreibungen, Bewertungszusammenfassungen und Kategorie-Tags und führen Sie eine Neugenerierung nur dann durch, wenn sich die zugrunde liegenden Daten ändern. Für Such- und Supportanfragen können Sie Antworten auf häufige, identische Anfragen zwischenspeichern.
Batch-APIs
Batch-APIs von Anthropic, OpenAI und Google verarbeiten Anfragen asynchron, in der Regel innerhalb von 24 Stunden, und bieten einen Rabatt von 50 % gegenüber den Standardpreisen. Sie eignen sich hervorragend für Hintergrundprozesse auf Marktplätzen: nächtliche Generierung von Beschreibungen, Neukategorisierung des Katalogs, Abarbeitung von Moderationsrückständen und Zusammenfassungen von Bewertungen. Batch-Rabatte lassen sich zudem mit Prompt-Caching kombinieren.
Dies unterscheidet sich davon, viele Elemente in einen einzigen Prompt zu packen. Das Gruppieren von 20 Artikeln in einer Anfrage kann zwar Anweisungen einsparen, führt aber zu längeren Ausgaben, erschwert die Fehlerisolierung und kann die Qualität beeinträchtigen, wenn das Modell den Überblick über die einzelnen Elemente verliert. Testen Sie die Paketgröße im Hinblick auf die Genauigkeit, anstatt davon auszugehen, dass mehr Inhalt automatisch günstiger ist.
Schritt 5: Verwaltung von Konversations- und Agentenkontext
Bei Chat-Assistenten und KI-Agenten steigt der Token-Verbrauch am schnellsten, da bei jedem Schritt der wachsende Verlauf erneut gesendet wird. Um dies unter Kontrolle zu halten:
- Behalten Sie nur die letzten paar Schritte wortgetreu bei und ersetzen Sie ältere durch eine kurze, fortlaufende Zusammenfassung.
- Verwerfen oder kürzen Sie alte Tool-Ergebnisse, sobald der Agent sie verwendet hat.
- Laden Sie Tool-Definitionen nur für die Funktionen, die für die aktuelle Aufgabe erforderlich sind.
- Legen Sie für jede Aufgabe Limits für die Anzahl der Schritte und die Gesamtzahl der Token fest, damit ein hängengebliebener Agent nicht in einer Endlosschleife landet.
Wenn Sie Agenten entwickeln, die mit Artikeln, Bestellungen oder Support-Tickets arbeiten, integriert unser Entwicklung maßgeschneiderter KI-Agenten Team diese Limits von Anfang an in den Workflow.
Praxisbeispiel: Bewertungszusammenfassungen auf Verkäuferprofilen
Stellen Sie sich einen Marktplatz vor, der ein LLM nutzt, um die Bewertungen jedes Verkäufers auf dessen Profilseite zusammenzufassen. Die folgenden Zahlen dienen der Veranschaulichung und basieren auf den Listenpreisen vom Oktober 2026.
Naiver Ansatz: Zusammenfassung bei jedem Profilaufruf. Gehen wir von 10.000 Profilaufrufen pro Tag aus, bei denen jeweils etwa 4.000 Input-Token an Bewertungen gesendet werden und eine 300-Token-Zusammenfassung von Claude Sonnet 5.5 zurückgegeben wird. Das entspricht 40 Millionen Input-Token (80 $) plus 3 Millionen Output-Token (30 $), also etwa 110 $ pro Tag.
Optimierter Ansatz: Zusammenfassungen einmalig generieren, speichern und nur bei Verkäufern aktualisieren, die neue Bewertungen erhalten haben. Wenn sich täglich 2.000 Verkäufer ändern, verbraucht ein nächtlicher Batch-Job 8 Millionen Input-Token und 0,6 Millionen Output-Token. Bei Sonnet 5.5 mit dem 50%-Batch-Rabatt sind das etwa 11 $ pro Tag. Wenn Tests zeigen, dass Claude Haiku 5.5 akzeptable Zusammenfassungen liefert, kostet derselbe Batch etwa 0,55 $ pro Tag. Profilaufrufe lesen nun direkt aus Ihrer Datenbank, ohne weitere Token-Kosten.
Der Kompromiss liegt in der Aktualität: Zusammenfassungen werden täglich statt sofort aktualisiert, was für diese Funktion völlig ausreicht. Dasselbe Prinzip „einmal berechnen, bei Änderung aktualisieren“ lässt sich auf Beschreibungen, Tags und andere Inhaltsaufgaben anwenden. Um zu sehen, wie sich solche Einsparungen auf die Margen pro Transaktion auswirken, lesen Sie unseren Leitfaden zu KI-Unit-Economics für Marktplätze.
Wann man optimieren sollte und wann sich die Kosten lohnen
Nicht jedes Feature ist den Optimierungsaufwand wert. Manchmal ist es die richtige Entscheidung, für ein leistungsfähigeres Modell mehr zu bezahlen, wenn dies die Conversion verbessert oder die Markteinführung beschleunigt.
Optimieren Sie, wenn:
- Das Feature ein Kernbestandteil ist und intensiv genutzt wird, wie etwa eine KI-Suche bei jeder Anfrage.
- Ihre Take-Rate oder Margen gering sind und daher die KI-Kosten pro Transaktion ins Gewicht fallen.
- Sie preissensible Nutzer bedienen und die Kosten nicht weitergeben können.
Warten Sie ab, wenn das Feature experimentell ist oder nur wenig genutzt wird. Veröffentlichen Sie eine einfache Lösung, messen Sie Qualität und Nutzung und optimieren Sie erst, wenn sich ein vorhersehbares Muster zeigt. Vorgefertigte Tools können ebenfalls helfen: unsere KI-Suchleiste und KI-Produktbeschreibungs-Generator Plugins für Sharetribe bieten Ihnen funktionierende Features, die Sie testen können, bevor Sie in individuelle Entwicklungen investieren.
Checkliste zur Token-Optimierung
- Token-Anzahl pro Anfrage, Funktion und Modell protokolliert
- Kontext auf erforderliche Felder und Top-Kandidaten gekürzt
- Stabiler Prompt-Präfix zuerst, dynamischer Inhalt zuletzt
- Maximale Ausgabe-Token und Ausgabeformat bei jedem Aufruf festgelegt
- Kleine Modelle für einfache Aufgaben verwendet, mit Eskalationsregeln
- Batch-APIs für alle nicht dringenden Aufträge genutzt
- Generierte Inhalte gespeichert und nur bei Änderungen aktualisiert
- Konversationsverlauf zusammengefasst und Agenten-Schleifen begrenzt
- Qualität nach jeder Änderung im Verhältnis zu den Kosten gemessen
Häufig gestellte Fragen
Was ist der Unterschied zwischen den Kosten für Eingabe- und Ausgabe-Token?
Eingabe-Token sind das, was Sie an das Modell senden (Prompt, Kontext und Daten). Ausgabe-Token sind das, was das Modell generiert, einschließlich etwaiger Reasoning-Token. Die Ausgabe ist teurer; bei Claude Sonnet 5.5 und gpt-6.1-sol kostet sie 10 $ pro Million gegenüber 2 $ für die Eingabe, ein Unterschied um den Faktor 5. Deshalb hat die Begrenzung der Ausgabelänge oft einen überproportionalen Einfluss auf die Kosten.
Wie stark kann ich den Token-Verbrauch realistisch senken?
Das hängt von Ihrem Ausgangspunkt ab. Wenn Sie bei jeder Anfrage vollständige Datensätze an ein Spitzenmodell senden, können Sie durch die Kombination von Kontextkürzung, Caching, Batch-Verarbeitung und Modell-Routing die Ausgaben drastisch senken, wie das obige Beispiel zeigt. Wenn Sie diese Grundlagen bereits angewendet haben, sind weitere Einsparungen eher gering. Messen Sie eine Basislinie, ändern Sie immer nur eine Sache nach der anderen und verfolgen Sie die Kosten pro erfolgreicher Aufgabe.
Beeinträchtigt die Optimierung der Token-Kosten die Qualität?
Nicht unbedingt. Prompt-Caching und Batch-APIs verändern die Ergebnisse überhaupt nicht. Kleinere Modelle und aggressive Komprimierung können die Qualität mindern, testen Sie diese daher an einem festen Evaluierungsset, bevor Sie sie einführen.
Funktioniert Prompt-Caching automatisch?
Das hängt vom Anbieter ab. OpenAI aktiviert das Caching für unterstützte Modelle standardmäßig, sobald Prompts die Mindestlänge erreichen. Bei Anthropic markieren Sie selbst, welche Teile der Anfrage zwischengespeichert werden sollen. In beiden Fällen benötigen Sie einen stabilen Präfix, um Treffer zu erzielen. Überprüfen Sie daher die Cache-Felder in den API-Antworten, um sicherzustellen, dass es funktioniert.
Wann sollte ich ein teureres Modell verwenden?
Verwenden Sie ein leistungsfähigeres Modell, wenn ein günstigeres Ergebnisse liefert, die Ihrem Produkt schaden, wie etwa falsche Kategorisierungen, mangelnde Suchrelevanz oder unsichere Moderationsentscheidungen. Nutzen Sie standardmäßig das günstigere Modell und eskalieren Sie nur bei Anfragen, die die Validierung nicht bestehen oder tiefergehendes Reasoning erfordern, auf ein stärkeres Modell.
KI-Funktionen profitabel skalieren
Die Reduzierung des Token-Verbrauchs ist keine einmalige Aufräumaktion, sondern ein wesentlicher Bestandteil bei der Entwicklung von KI-Funktionen, die auch bei wachsendem Marktplatz Bestand haben. Wenn Sie neue KI-Funktionen planen, hilft Ihnen unsere KI-Strategie- und Architektur- Arbeit dabei, Modelle auszuwählen und Pipelines zu entwerfen, bevor die Kosten feststehen, und unser benutzerdefinierten Marktplatzprojekts Team integriert diese in Ihre Plattform.
Sie nutzen bereits KI-Funktionen und sehen zu, wie die Kosten steigen? Unser KI-Kostenoptimierung Service analysiert Ihren Token-Verbrauch, Ihre Prompts sowie Ihre Architektur und setzt diese Einsparungen direkt in die Produktion um.