LLM-Kostenüberwachung für Marktplätze: KI-Ausgaben unter Kontrolle halten

Wenn Sie einen Marktplatz mit KI-Funktionen aufbauen oder skalieren, ist die Verwaltung der Ausgaben für Large Language Models (LLMs) mittlerweile genauso wichtig wie die Verwaltung der Serverinfrastruktur. Die meisten Teams entdecken das Problem auf die harte Tour: Eine Funktion wird veröffentlicht, die Nutzung nimmt zu, und einen Monat später trifft die Rechnung des Anbieters in doppelter Höhe des Erwarteten ein. Das Abrechnungs-Dashboard zeigt Ihnen zwar, wie viel Sie ausgegeben haben, aber nicht warum. Sie können nicht sehen, welche Funktion die Token verbraucht hat, welche Nutzer die teuren Workflows ausgelöst haben oder wo Wiederholungsversuche und Agenten-Schleifen die Rechnung in die Höhe getrieben haben.
Genau diese Lücke schließt die LLM-Kostenüberwachung. Bei Journeyhorizonentwickeln wir seit 2018 Marktplätze und arbeiten mit Gründern zusammen, die bei der Skalierung ihrer KI-Funktionen genau auf diese Hürde stoßen. Dieser Leitfaden behandelt, was Sie nachverfolgen sollten, wie Sie es einrichten, welche Warnmeldungen Sie konfigurieren müssen und wie Sie die Daten in geringere Kosten umwandeln, ohne die Qualität zu beeinträchtigen.
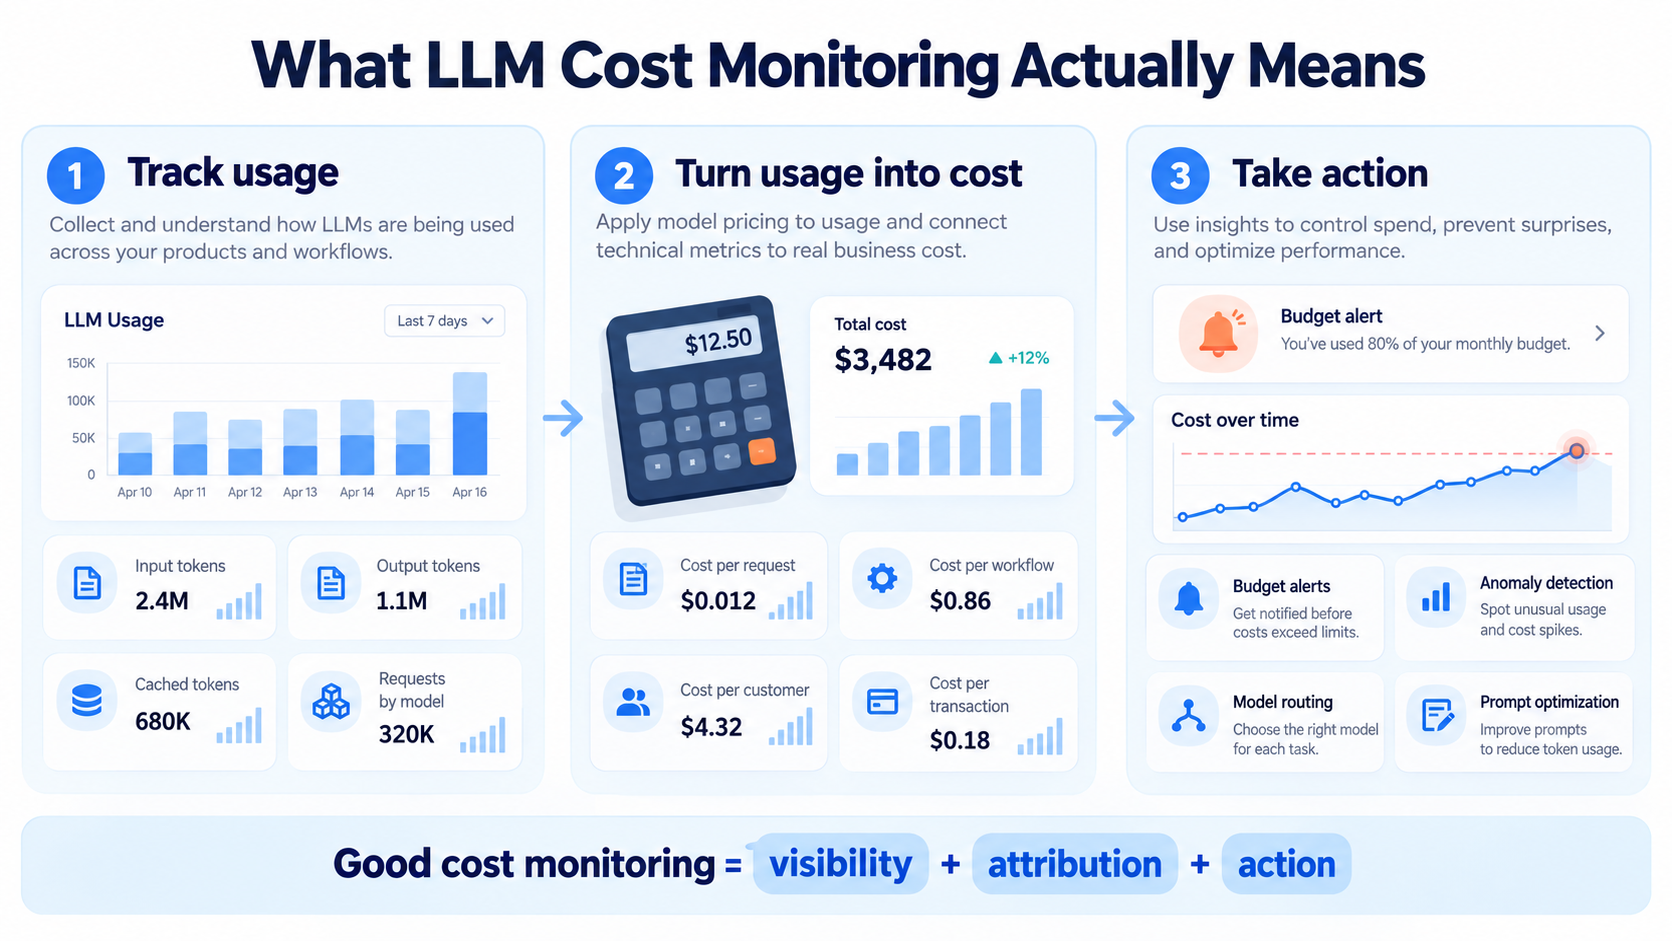
Was LLM-Kostenüberwachung eigentlich bedeutet
LLM-Kostenüberwachung ist die Praxis, die durch Modell-API-Aufrufe in der Produktion verursachten Ausgaben kontinuierlich zu messen, zuzuordnen und zu optimieren. Anbieter berechnen Kosten pro Token, mit separaten Preisen für Input und Output, und jedes Modell hat seine eigene Preisliste. Das macht die Kosten zu einer Funktion von drei Dingen, die Sie kontrollieren: welches Modell Sie aufrufen, wie viele Token Sie senden und wie viele Token Sie zurückerhalten.
Observability-Anbieter wie Datadog berechnen Kosten auf die gleiche Weise: Token-Anzahl pro LLM-Span multipliziert mit den öffentlichen Preisen des Anbieters, mit der Option, diese durch ausgehandelte Raten zu überschreiben. Die Dokumentation von Datadog unterteilt Input-Token zudem in nicht zwischengespeicherte (non-cached), Cache-Read- und Cache-Write-Token und behandelt Reasoning-Token als Teilmenge des Outputs. Dieser Detaillierungsgrad ist wichtig, da zwischengespeicherter Input oft nur einen Bruchteil des normalen Preises kostet und Reasoning-Token die Output-Kosten unbemerkt in die Höhe treiben können.
Für Marktplatz-Teams ist Granularität das A und O. Eine Retrieval-Pipeline, die Produktlisten in den Prompt einfügt, kann ein Vielfaches der Token einer einfachen Suchanfrage verbrauchen. Ein Agent, der einen fehlgeschlagenen Tool-Aufruf wiederholt, kann das Budget in Minuten aufzehren. Ein Massenimport, der ein Frontier-Modell verwendet, wo ein kleines ausreichen würde, verbrennt Geld ohne sichtbare Anzeichen. Ohne Transparenz auf Ebene der einzelnen Aufrufe bleiben diese Muster verborgen, bis die Rechnung eintrifft.
Warum Marktplatz-LLM-Kosten schwer vorhersehbar sind
Marktplätze sehen sich mit Kostendynamiken konfrontiert, die bei einseitigen SaaS-Produkten normalerweise nicht auftreten.
Mehrere Modelle auf beiden Seiten des Marktes
Die meisten KI-gestützten Marktplätze betreiben mittlerweile mehrere Modelle gleichzeitig: eines für Tools für Verkäufer, ein weiteres für die Suche und Empfehlungen für Käufer und möglicherweise ein drittes für Moderation oder Support. Wenn Sie noch dabei sind, die Einsatzmöglichkeiten von KI zu planen, bietet unser Überblick über wie Marktplätze KI nutzen Informationen zu den gängigen Funktionen. Jedes Modell hat eine unterschiedliche Preisgestaltung, und die Unterschiede zwischen den Stufen sind groß. Stand Oktober 2026 liegen Claude Sonnet 5.5 und OpenAI gpt-6.1-sol bei 2 $ pro Million Input-Token und 10 $ pro Million Output-Token, während Claude Haiku 5.5 und gpt-6-luna bei 0,10 $ bzw. 0,50 $ liegen. Das ist ein 20-facher Unterschied für die gleiche Anzahl an Token. Eine detailliertere Aufschlüsselung der Preislisten und versteckten Gebühren finden Sie in unserem LLM-API-Preisvergleich für Marktplätze.
Ungleichmäßige, ereignisgesteuerte Nutzung
Die Nutzung auf Marktplätzen ist selten gleichbleibend. Eine Onboarding-Aktion für Verkäufer kann an einem Tag Tausende von Aufrufen zur Anreicherung von Angeboten auslösen. Eine Marketingkampagne kann das Suchvolumen der Käufer über Nacht vervielfachen. Ohne eine Aufschlüsselung der Ausgaben nach Funktion, Kohorte oder Marktsegment verbringen Teams Wochen damit, zu erraten, welche Änderung den Anstieg verursacht hat.
Agenten-Workflows vervielfachen Aufrufe
Eine einzige Nutzeranfrage an einen Agenten kann Retrieval, Routing, Tool-Aufrufe, Wiederholungsversuche und Sicherheitsprüfungen auslösen. Gartner prognostizierte im August 2026, dass die KI-Inferenzkosten pro Agenten-Workflow bis 2028 um mehr als das Fünffache steigen werden, selbst wenn die Preise pro Token sinken, da leistungsfähigere Workflows weitaus mehr Token verbrauchen. Günstigere Token allein werden Ihre Rechnung nicht stabil halten.
Kosten, die nie auf der erwarteten Rechnungsposition erscheinen
Embedding-Aufrufe für die Suche, Re-Ranking, Vektordatenbank-Abfragen und Wiederholungsversuche nach Timeouts verursachen zusätzliche Kosten. Eine Funktion, die in der Staging-Umgebung günstig aussieht, kann unter Produktionslast unbezahlbar werden, wenn sie nicht auf Token-Effizienz ausgelegt wurde. Deshalb gehört die Kostentransparenz in die Entwicklungsphase jedes benutzerdefinierten Marktplatzprojekts Projekt, nicht erst nach dem Start.</SEGMENT 1]
Die entscheidenden Kennzahlen für die Kostenkontrolle auf Marktplätzen</SEGMENT 2]
Nicht jede Kennzahl verdient einen Platz auf dem Dashboard. Konzentrieren Sie sich auf die Werte, die geschäftliche Entscheidungen vorantreiben:</SEGMENT 3]
- Token pro Anfrage:</SEGMENT 4] normalisiert die Nutzung und macht aufgeblähte Prompts leicht erkennbar.</SEGMENT 5]
- Kosten pro Marktplatz-Operation:</SEGMENT 6] die Kosten für eine Anreicherungen von Angeboten, eine Suche, eine Support-Antwort oder eine Moderationsprüfung. Dies ist die Kennzahl, auf der Produktentscheidungen basieren sollten.</SEGMENT 7]
- Kosten pro Nutzer, Mandant und Marktseite:</SEGMENT 8] ermöglicht eine interne Leistungsverrechnung und zeigt auf, ob Käufer oder Verkäufer die Ausgaben treiben.</SEGMENT 9]
- Verhältnis von Ausgabe- zu Eingabe-Token:</SEGMENT 10] Ausgabe-Token kosten bei den meisten Modellen ein Vielfaches der Eingabe-Token, daher erfordern wortreiche Antworten Aufmerksamkeit.</SEGMENT 11]
- Cache-Trefferquote:</SEGMENT 12] zeigt, wie viel wiederholter Kontext über günstigere zwischengespeicherte Token oder einen semantischen Cache bereitgestellt wird.</SEGMENT 13]
- Anteil des Traffics auf Premium-Modellen:</SEGMENT 14] deckt Routineaufgaben auf, die auf ein kleineres Modell verlagert werden könnten.</SEGMENT 15]
- Budgetverbrauch und Anomalien:</SEGMENT 16] erkennt Regressionen, Fehlkonfigurationen und Endlosschleifen, bevor sie auf der monatlichen Abrechnung landen.</SEGMENT 17]
- Qualitätsbewertung im Vergleich zu den Kosten:</SEGMENT 18] ein Bewertungsscore oder Nutzerfeedback, damit Sie Kosten nie blindlings senken.</SEGMENT 19]
Die Kosten pro Operation sind der Punkt, an dem Monitoring auf Geschäftsmodellierung trifft. Wenn die KI-gestützte Anreicherung von Angeboten mehr kostet als die Provision, die ein typisches Angebot im ersten Monat generiert, benötigt die Funktion ein günstigeres Modell oder einen anderen Auslöser. Unser Leitfaden zu </SEGMENT 20] KI-Unit-Economics für Marktplätze zeigt, wie diese Zahlen in den Deckungsbeitrag einfließen, und unser Erklärartikel zum Thema Marktplatz-Kommissionsmodell behandelt die Umsatzseite.
Ein Praxisbeispiel: Anreicherung von Angeboten in großem Maßstab
Hier ist eine einfache Veranschaulichung auf Basis der Listenpreise vom Oktober 2026. Nehmen wir an, jeder Aufruf zur Anreicherung eines Angebots sendet etwa 1.500 Eingabe-Token (Anweisungen, Kategorieschema und Verkäufertext) und liefert etwa 300 Ausgabe-Token zurück.
- Mit Claude Sonnet 5.5 (2 $ / 10 $ pro Million): etwa 0,003 $ für die Eingabe plus 0,003 $ für die Ausgabe, also rund 0,006 $ pro Angebot. Bei 100.000 Angeboten im Monat sind das etwa 600 $.
- Mit Claude Haiku 5.5 (0,10 $ / 0,50 $ pro Million): etwa 0,0003 $ pro Angebot, also rund 30 $ im Monat bei gleichem Volumen.
- Mit einer Batch-API: OpenAI, Anthropic und Google bieten für Aufträge, die nicht sofort bearbeitet werden müssen, eine Batch-Verarbeitung mit 50 % Rabatt an, was beide Beträge halbieren würde.
Die genauen Zahlen hängen von Ihren Prompts ab, aber das Muster bleibt bestehen: Die Wahl des Modells und der Verarbeitungsmodus können die Kosten für dieselbe Funktion um eine Größenordnung verändern. Durch Monitoring finden Sie heraus, welche Funktionen diese Analyse wert sind. Einen umfassenderen Überblick über die Kosten für den Modellzugriff in verschiedenen Größenordnungen finden Sie unter wie viel ein LLM kostet.
Aufbau einer Grundlage für das Kostenmonitoring
Ein praxisorientierter Aufbau besteht aus drei Ebenen.
1. Einheitliche Beobachtbarkeit
Leiten Sie den gesamten Inferenz-Traffic, egal ob an API-Modelle oder einen selbst gehosteten Cluster, über ein zentrales Gateway oder eine gemeinsame Instrumentierungsschicht. Erfassen Sie Metadaten zu jeder Anfrage: Benutzer- oder Mandanten-ID, Funktionsname, Umgebung und Modell. Taggen Sie von Anfang an konsistent, denn Kosten ohne Kontext sind nur eine Zahl. Gängige Implementierungsoptionen sind:
- Middleware-Logging: ein schlanker Wrapper um Ihre Provider-SDKs, der Token-Anzahl und Kosten in Ihre bestehenden Logs oder Ihr Data Warehouse schreibt.
- OpenTelemetry-Spans: Token- und Kostenattribute für jeden LLM-Span, die an Grafana, Datadog oder ein anderes Backend gesendet werden.
- KI-Gateways und Tools zur LLM-Beobachtbarkeit: Produkte wie Helicone, Portkey, LiteLLM, Langfuse oder Comet Opik berechnen die Kosten pro Anfrage automatisch und ergänzen Funktionen für Budgets, Caching und Fallbacks.
2. Governance
Sobald Sie die Kosten im Blick haben, können Sie Limits durchsetzen, bevor Budgets überschritten werden. Legen Sie tägliche oder monatliche Kontingente pro Benutzer, Funktion, Mandant oder Umgebung fest. Ein sinnvolles Einstiegsmuster:
- Eine Warnmeldung bei etwa 80 % eines Tages- oder Monatsbudgets.
- Eine kritische Warnung und optional eine Drosselung bei 100 %.
- Ein Anomalie-Alarm, wenn die Ausgaben das Mehrfache des normalen Stundensatzes erreichen, was meist auf eine Endlosschleife oder einen Fehler hindeutet.
- Ratenbegrenzungen pro Benutzer für kostenintensive Funktionen, damit ein einzelnes Konto oder ein fehlerhaftes Skript die Kosten nicht in die Höhe treibt.
Einige Teams blockieren Anfragen automatisch bei einer harten Obergrenze; andere benachrichtigen einen Slack-Kanal, damit ein Mensch entscheiden kann. In jedem Fall kommt ein Bericht, der erst nach der Rechnung eintrifft, zu spät. Für größere Unternehmen können formelle KI-Governance-Dienste diese Kontrollen auf Zugriffsrichtlinien, Datenverarbeitung und Audit-Protokolle ausweiten.
3. Kontinuierliche Optimierung
Mit Transparenz und Leitplanken wird die LLM-Kostenüberwachung zu einem fortlaufenden Prozess, bei dem die größten Kostentreiber identifiziert und ohne Qualitätseinbußen reduziert werden. Dieser Prozess wird im nächsten Abschnitt behandelt.
Intelligente Strategien zur Kostenoptimierung
Modell-Routing. Leiten Sie einfache Aufgaben mit hohem Volumen, wie Klassifizierungen, Tagging und kurze Zusammenfassungen, an kleine Modelle weiter und reservieren Sie Spitzenmodelle für komplexe Schlussfolgerungen oder hochwertige Kundeninteraktionen. Gartner empfiehlt aus genau diesem Grund ein Multi-Modell-Tiering und -Routing. Optionen der mittleren Kategorie wie Gemini 3.8 Flash liegen mit 0,75 $ für Input und 3,75 $ für Output pro Million Token genau zwischen den beiden Extremen.
Prompt-Caching. Marktplatz-Prompts wiederholen oft lange Systemanweisungen, Kategorietaxonomien oder Richtlinientexte. Anbieter berechnen gecachte Eingaben mit einem hohen Rabatt; so kosten beispielsweise gecachte Lesezugriffe bei Claude Sonnet 5.5 0,10 $ pro Million Token im Vergleich zu 2 $ für reguläre Eingaben. Platzieren Sie stabile Inhalte am Anfang des Prompts, damit sie gecacht werden können.
Semantisches Caching. Speichern Sie Antworten und verwenden Sie diese für nahezu identische Anfragen wieder, wie etwa bei häufigen Kundensuchen oder wiederkehrenden Support-Fragen. Überwachen Sie die Cache-Trefferquote, um sicherzustellen, dass sich dies auszahlt.
Batch-Verarbeitung. Massenimporte, die Neukategorisierung von Katalogen und nächtliche Anreicherungs-Jobs erfordern selten Echtzeit-Antworten. Die Verlagerung auf Batch-APIs halbiert die Kosten für diese Aufrufe.
Schlankere Prompts und strukturierte Ausgaben. Kürzen Sie redundante Anweisungen, begrenzen Sie den Umfang des erneut gesendeten Gesprächsverlaufs und beschränken Sie Ausgaben durch ein Schema, damit die Antworten kurz und vorhersehbar bleiben. Weniger fehlerhafte Ausgaben bedeuten auch weniger Wiederholungsversuche. Unser Leitfaden zu Reduzierung der Token-Nutzung erläutert diese Techniken im Detail.
Limits für Agenten-Schleifen. Begrenzen Sie die Anzahl der Tool-Aufrufe und Wiederholungsversuche pro Anfrage und protokollieren Sie, wenn ein Agent das Limit erreicht. Endlosschleifen sind eine der häufigsten Ursachen für plötzliche Lastspitzen.
Self-Hosting bei stabilem Volumen. Open-Weight-Modelle, die auf der eigenen Infrastruktur bereitgestellt werden, können bei hoher und vorhersehbarer Auslastung günstiger sein als API-Preise pro Token. Berücksichtigen Sie GPU-Kosten, Entwicklungszeit und Wartungsaufwand, bevor Sie umsteigen, und nutzen Sie Ihre Monitoring-Daten, um den Break-even-Punkt zu berechnen.
Kostenüberwachung mit der Entwicklung von Marktplätzen verbinden
Kostenannahmen prägen die Architektur. Ein Entwicklung Ihrer Marktplatz-App Ein Partner, der ohne Verständnis für Token-Ökonomie entwickelt, liefert möglicherweise Funktionen, die in der Staging-Umgebung gut funktionieren, aber unter Produktionslast nicht tragfähig sind. Kalkulieren Sie die Kosten ab dem ersten Sprint, überprüfen Sie Kostenschätzungen während des technischen Designs und behandeln Sie Kosten als Leistungskennzahl, genau wie Latenz und Durchsatz.
Dies gilt auch für fertige KI-Komponenten. Wenn Sie eine KI-gestützte Funktion hinzufügen, wie zum Beispiel eine KI-Suchleiste für Sharetribe, kennzeichnen Sie deren Aufrufe separat, damit Sie sehen können, was die Suche tatsächlich pro Sitzung und pro konvertiertem Käufer kostet.
Erste Schritte: Eine 30-Tage-Checkliste
- Woche 1: Kapseln Sie jeden LLM-Aufruf in einem gemeinsamen Client, der Token, Modell, Kosten, Funktion sowie die Benutzer- oder Mandanten-ID protokolliert.
- Woche 1: Gleichen Sie Ihre protokollierten Summen mit der Rechnung des Anbieters ab, um sicherzustellen, dass Ihre Preistabelle korrekt ist.
- Woche 2: Erstellen Sie ein einfaches Dashboard, das die Gesamtausgaben, die Ausgaben pro Funktion, pro Modell und die Kosten pro Marktplatz-Operation anzeigt.
- Woche 2: Konfigurieren Sie Budgetwarnungen, feste Obergrenzen und einen Alarm für Anomalien.
- Woche 3: Bewerten Sie Funktionen nach Kosten und wählen Sie die drei bis fünf größten Kostentreiber aus. Bei vielen Produkten entfällt der Großteil der Rechnung auf eine kleine Anzahl von Funktionen.
- Woche 3 bis 4: Testen Sie für jeden Treiber eine Änderung: ein günstigeres Modell, ein kürzerer Prompt, Caching oder Batch-Verarbeitung. Messen Sie Kosten und Qualität gemeinsam.
- Woche 4: Implementieren Sie die Änderungen, bei denen die Qualität erhalten bleibt, machen Sie die anderen rückgängig und planen Sie eine regelmäßige monatliche Überprüfung ein.
Teams, die dies als fortlaufende Disziplin und nicht als einmaliges Audit betrachten, vermeiden Kostenüberraschungen und halten KI-Funktionen bei der Skalierung wirtschaftlich nachhaltig.
Häufig gestellte Fragen
Was ist LLM-Kostenüberwachung?
Es ist die Praxis, die Token-Nutzung und die Ausgaben für jeden Modellaufruf in der Produktion zu verfolgen, diese Ausgaben Funktionen, Benutzern und Modellen zuzuordnen und Warnungen sowie Budgets zu nutzen, um die Kosten unter Kontrolle zu halten.
Warum reicht das Abrechnungs-Dashboard des Anbieters nicht aus?
Die Dashboards der Anbieter zeigen Summen nach Modell und API-Schlüssel. Sie wissen jedoch nicht, welche Marktplatz-Funktion, welcher Nutzer oder welcher Workflow den jeweiligen Aufruf ausgelöst hat. Daher können sie Ihnen nicht sagen, warum sich die Ausgaben verändert haben oder welche Funktion unrentabel ist.
Welche Kennzahlen sollte ein Marktplatz zuerst verfolgen?
Beginnen Sie mit den Kosten pro Funktion, den Kosten pro Marktplatz-Vorgang, den Token pro Anfrage und den Ausgaben pro Modell. Sobald die Grundlagen stehen, können Sie die Cache-Trefferquote, das Verhältnis von Output zu Input und Qualitätsbewertungen hinzufügen.
Brauche ich ein spezielles Tool oder kann ich es selbst entwickeln?
Teams in der Frühphase können mit Middleware-Logging in einen bestehenden Log- oder Analyse-Stack starten. Mit zunehmendem Volumen an Aufrufen, Modellen und Funktionen sparen ein AI-Gateway oder eine LLM-Observability-Plattform Entwicklungszeit und bieten sofort Funktionen für Budgetierung, Caching und Routing.
Wie stark kann Monitoring die LLM-Kosten senken?
Monitoring allein spart nichts; die dadurch aufgedeckten Optimierungen sind entscheidend. Die Umstellung einer Aufgabe mit hohem Volumen auf ein kleineres Modell kann die Kosten bei aktuellen Listenpreisen um mehr als 90 % senken, und Batch-APIs halbieren den Preis für geeignete Aufträge. Die tatsächlichen Einsparungen hängen davon ab, wie viel Ihres Traffics ohne Qualitätseinbußen verlagert werden kann.
Wie oft sollten wir die LLM-Ausgaben überprüfen?
Warnmeldungen sollten kontinuierlich laufen. Überprüfen Sie das Kosten-Dashboard wöchentlich während Produkteinführungen oder schnellem Wachstum und mindestens monatlich, sobald sich die Nutzung stabilisiert hat – sowie immer dann, wenn ein Anbieter seine Preise ändert.
Sorgen Sie dafür, dass sich KI-Funktionen rentieren
Wenn Sie Kosten von Anfang an als zentrale Kennzahl betrachten, treffen Sie bessere technische Entscheidungen und machen die Skalierung von KI-Funktionen deutlich risikoärmer. Das Team von Journeyhorizon mit fast 60 Spezialisten hat über 200 Projekte umgesetzt und kombiniert Marktplatz-Entwicklung mit praktischer LLM-Integration. Wenn Ihre KI-Rechnung schneller wächst als Ihr Marktplatz, kann unser Dienstleistungen zur KI-Kostenoptimierung Ihnen dabei helfen, Ausgaben zu erfassen, zu bewerten und zu senken, ohne die Funktionen zu beeinträchtigen, auf die sich Ihre Nutzer verlassen.